单元六
第21课 借用机器学习工具箱——认识sklearn

一、任务目标
理解 sklearn 等工具箱提供现成的训练与预测接口,本课只要求认识「拟合—预测」用法,不要求推导算法公式。
二、我们要学什么
- 学习要点:借用机器学习工具箱|认识sklearn
- 本课过关:能完成:说出工具箱把训练封装成可调用步骤;指出先准备带标签数据,再 fit,再对新年预测;能说明仍须把测试与训练分开。
- 示例对齐:体验题对应本课「编程体验」;完整代码对应编程题1;补全与独立编写对应编程题2–3。均在 Mixly 图形化积木中完成。
三、本节要点
本课要认识现成工具箱。重难点是会调用接口、仍要自己准备数据和测试,而不是把工具箱当成魔法。要点对齐「借用机器学习工具箱|认识sklearn」。
1读场景明确真实任务
2对要点借用机器学习工具箱|认识sklearn
3载入运行图形化积木
四、解题思路
任务:认识用工具箱完成一次拟合与预测。请分清:数据仍要自己准备,公式不必手推。
本课主要用到:Mixly 图形化积木与屏幕输出。
- 1明确任务「调用现成接口」:先有带标签数据,再训练,再预测。
- 2按工具箱的拟合、预测顺序调用。
- 3用未参与训练的样本检查,确认不是背题。
流程示意(可对照左侧文字)
五、图形块功能讲解
下面只列出本课首次出现的 Mixly 图形块(真积木截图)。已在前面课讲过的不再重复;先认新块,再点「载入」对照拖搭。
| 图形块 | 分类 | 作用 | 本课用法 |
|---|---|---|---|
 | 机器学习 | 用已标注数据学习(fit)。 | 本课编程练习中首次使用,载入后可在工具箱对照。 |
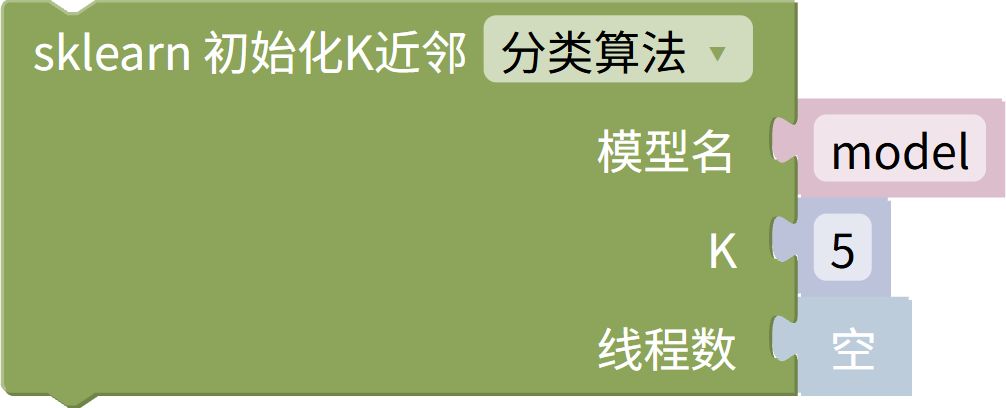 | 机器学习 | 创建近邻模型,用于分类或回归。 | 本课编程练习中首次使用,载入后可在工具箱对照。 |
六、知识点讲解
机器学习工具箱把常用算法做成可调用接口:准备好带标签数据后拟合,再对新例子预测。本课只认识「拟合—预测」两步,不推导内部公式。数据和测试仍须自己把关,工具箱不能代替。
先弄清:工具箱能调用,数据与测试不能省;再进练习对照一次预测。
七、编程练习
用下拉列表切换题目;下方 Mixly 默认显示图形化积木。请在 Mixly 工具栏点「运行」;「检查」读取 Mixly 代码自动判题。请先读本页「四、解题思路」与「五、图形块功能讲解」,再点载入。
参考代码(对照抄写到下方 Mixly)
from sklearn.neighbors import KNeighborsClassifier

def sk_train(X, y):
    clf = KNeighborsClassifier(n_neighbors=1)
    clf.fit(X, y)
    return clf

def sk_accuracy(clf, X, y_true):
    return clf.score(X, y_true)

# 兴趣近邻:左下 A 组,右上 B 组
X = [[1, 1], [2, 1], [8, 8], [9, 8]]
y = ["A组", "A组", "B组", "B组"]
model = sk_train(X, y)
print(model.predict([[1, 2]]))
print(sk_accuracy(model, [[2, 2], [8, 9]], ["A组", "B组"]))
正在载入编程环境
正在载入 Mixly 图形化编程环境…
八、课堂练习
先完成两道正误判断,再做其余题目;选出后点「检查」。
判断:调用工具箱时,仍要把训练和测试分开,库给的分数也要人来解释。
判断:只要成功 import sklearn,就可以不管数据隐私,也不用说明 fit 和 predict 在做什么。
大体上,「训练模型」对应工具箱里的?
对新年样本给出类别,对应?
KNeighborsClassifier 的思路更接近本册的?
九、本节小结
本课主题是认识工具箱:用现成接口完成拟合与预测。不必手推公式,但训练与测试仍要分开。