单元二 · 文本的智能生成
第5课 文本处理的基本单位
一、学习目标
- 理解人工智能处理自然语言时的基本单位。
- 了解人与机器分词的差异。
- 了解一种自动构建词表的算法思想。
- 了解一种自动分词算法的实现过程。
二、情境导入
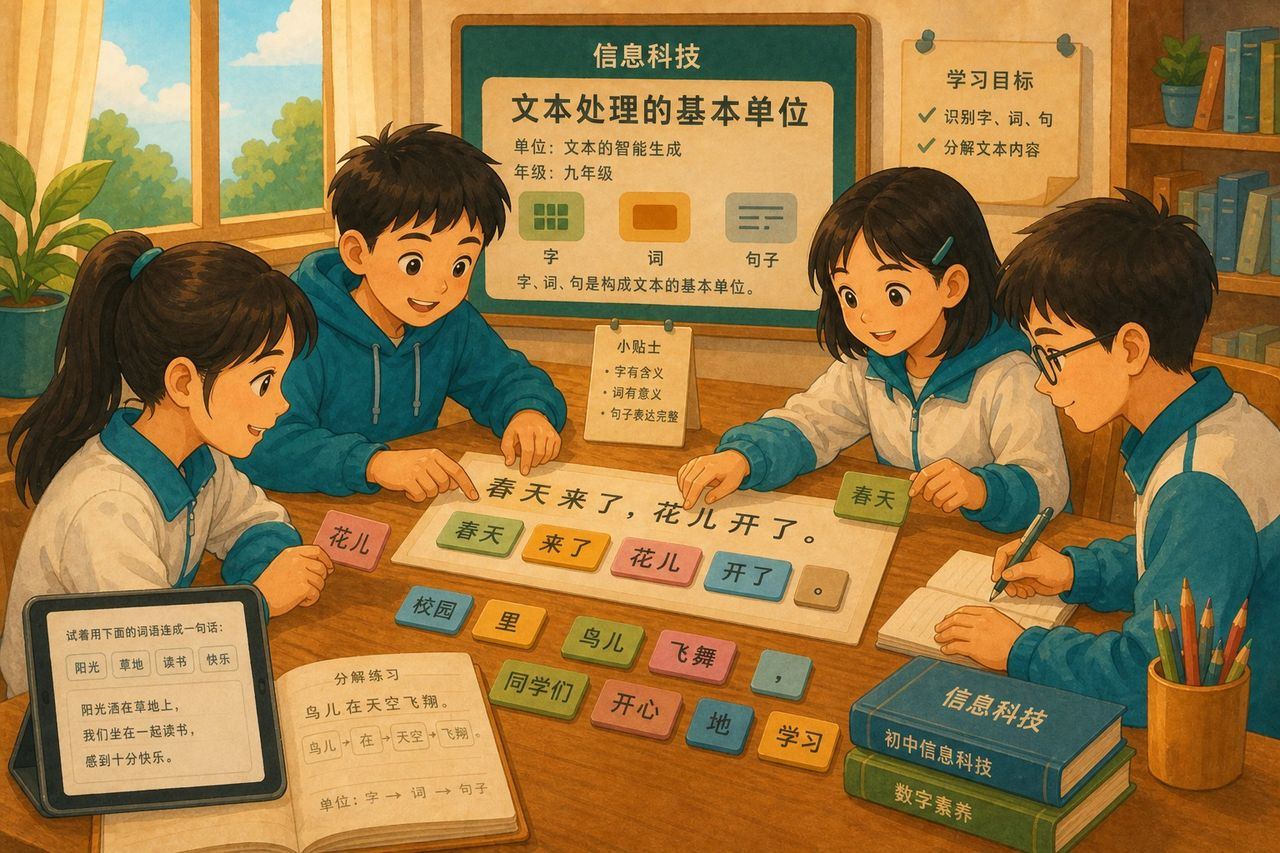
人工智能如何「处理」人类语言?首先要弄清它的基本单位。
卡片中的单字词、双字词、多字词等,都可视为记号(token)。
三、核心讲解
本课学习路径:
1词与分词
2自动构建词表
3自动分词
1.词与分词
人工智能处理自然语言的基本单位是记号(token),日常也称词或词元。把文本切成基本单位的过程叫分词。
token(记号):可以是适合人读的词、子词(如 un/happy),或单字;不同模型策略不同,token 数量影响处理代价。
- 人分词靠语言能力;机器分词结果可能差别很大
- 可用分词与词云等组件感受「词」如何被切出
- 面向人的分词(如部分中文分词库)未必最适合模型内部表示
想一想:同一句话,切成「词」或切成「字」,对后面的统计与生成会有什么影响?
2.自动构建词表
分词常先有词表,再按规则匹配。新词不断出现,纯人工维护词表越来越难,因而需要自动构建。
统计构词:从单字出发,反复把在原文中相邻且高频的字符合并进词表,逐步得到「人工」「智能」「人工智能」等组合。
- 对比长串优先与短串优先等匹配策略对切分结果的影响
- 实际系统常「机器提候选 + 人工审核」:限词长、剔无意义组合
想一想:若从不合并高频相邻字,词表会停留在什么水平?
3.自动分词
现代语言模型广泛使用基于统计的分词/构词思想;机器并非「懂意思」,而是计算出现与组合的可能性。
统计本质:分词与构词依赖共现与频率等信号;理解其统计本质,有助于解释不同分词器结果为何不同。
- 在文本分词相关组件中对比不同方式的切分结果
- token 数可类比「流量」:输入与输出阶段都要计入
想一想:遇到一段陌生古代文字、没有现成词表时,你可以借鉴本课哪一步?
弄清以上要点后,再进入下方动手体验,用实际操作验证。
四、动手体验 · MixAI 组件
请在下列组件中完成操作,至少体验一个并记录现象。
组件 model_word_segmentation — 在框内完成操作
五、课堂总结
- 处理文本的基本单位是记号(token),也称词或词元。
- 基于词频统计的分词/构词思想广泛应用于现代语言模型。
- 机器并非真正「理解」句意,而是通过统计与计算完成切分与组合。
六、拓展提升
- 假设面对一段未知规则的古代文字且无现成词表,借助本课统计构词思想,说明如何初步找「词」。
测评
对照本课学习目标作答(客观题练习);选出后点「检查」。答错会显示简短说明。
人工智能处理自然语言时的基本单位通常称为:
自动构建词表时,常见做法是:
判断:机器分词一定是因为它已经完全理解了句子意思。
本节小结
回顾本课要点,完成动手体验与测评。记住:文本处理的基本单位。